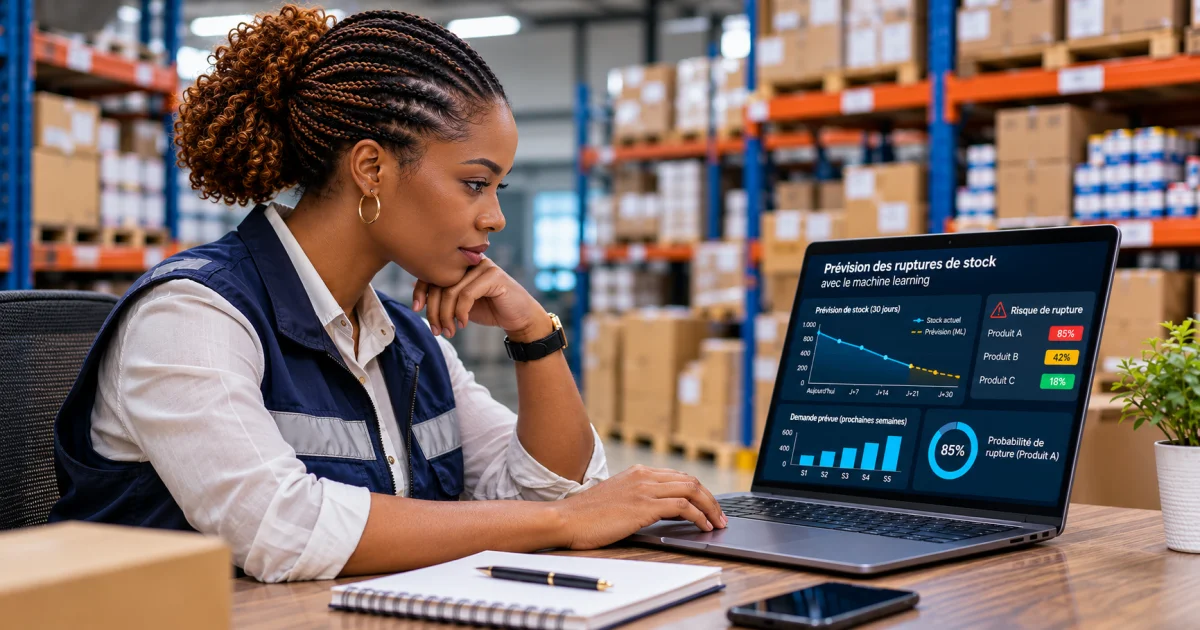
Un produit se vend bien depuis plusieurs semaines. Les commandes augmentent, les clients reviennent et les ventes semblent satisfaisantes. Puis, un matin, le magasin découvre que le stock est épuisé. Le fournisseur ne peut livrer que plusieurs jours plus tard.
Cette situation pose une question importante : pouvait-on anticiper la rupture avant qu'elle ne se produise ?
Dans de nombreux cas, la réponse est oui, à condition de disposer de données suffisamment fiables. Les techniques de prévision statistique et de Machine Learning peuvent aider à estimer la demande future, à détecter les risques de rupture de stock et à mieux planifier les approvisionnements.
Mais prévoir les ventes ne suffit pas. Une entreprise doit également connaître ses stocks disponibles, ses commandes en cours, les délais de livraison de ses fournisseurs et les conséquences économiques d'une rupture.
1. Pourquoi les ruptures de stock représentent-elles un problème ?
Une rupture de stock survient lorsqu'un produit demandé n'est plus disponible en quantité suffisante pour satisfaire les commandes.
Ses conséquences peuvent aller au-delà d'une vente manquée :
- perte de chiffre d'affaires lorsque le client renonce à son achat ;
- déplacement d'une partie de la clientèle vers un concurrent ;
- commandes urgentes auprès des fournisseurs, parfois plus coûteuses ;
- perturbation des activités lorsqu'une matière première ou une pièce indispensable manque ;
- mobilisation supplémentaire des employés pour rechercher des solutions de remplacement.
À l'inverse, commander systématiquement de grandes quantités n'est pas une solution universelle. Le surstockage immobilise de la trésorerie, occupe de l'espace et peut entraîner des pertes, notamment lorsque les produits sont périssables ou deviennent rapidement obsolètes.
L'objectif d'une bonne gestion des stocks consiste donc à trouver un équilibre entre la disponibilité des produits et le coût de leur conservation.
2. Que peut réellement prédire le Machine Learning ?
Le Machine Learning regroupe des méthodes permettant à un système informatique d'apprendre des relations à partir de données historiques afin de produire des prédictions sur de nouvelles situations.
Dans la gestion des stocks, il peut servir à plusieurs tâches distinctes :
- Prévoir la demande : estimer les quantités susceptibles d'être demandées dans les prochains jours ou les prochaines semaines.
- Estimer le risque de rupture : déterminer si le stock disponible risque de devenir insuffisant avant le prochain approvisionnement.
- Identifier des comportements inhabituels : repérer une augmentation soudaine de la consommation d'un produit.
- Préparer le réapprovisionnement : fournir des prévisions utilisables dans le calcul des seuils de commande.
Il faut distinguer deux questions. Prédire que les clients demanderont 200 unités la semaine prochaine ne signifie pas nécessairement qu'une rupture se produira. Si le magasin dispose de 500 unités, la situation est différente de celle d'un magasin qui n'en possède que 40.
Le risque de rupture dépend donc à la fois de la demande future, des stocks réellement disponibles et du délai nécessaire pour recevoir de nouvelles marchandises.
3. Quelles données faut-il collecter ?
Un système prédictif ne commence pas par le choix d'un algorithme. Il commence par l'inventaire des données que l'entreprise possède déjà.
Pour un commerce, un dépôt ou une entreprise de distribution, les informations suivantes peuvent être utiles :
DonnéeUtilité Historique des ventesObserver l'évolution des quantités vendues Dates des transactionsRepérer les tendances et variations périodiques Références produitsPrévoir la demande pour chaque article Stocks disponiblesÉvaluer les quantités immédiatement mobilisables Réceptions et commandes en coursAnticiper les entrées futures en stock Délais fournisseursEstimer la durée de réapprovisionnement Promotions et changements de prixInterpréter certaines variations de la demande Points de venteDistinguer les besoins de plusieurs magasinsCes informations peuvent provenir d'un logiciel de gestion commerciale, d'un ERP, d'un système de caisse ou de fichiers Excel correctement structurés.
Un historique volumineux n'est pas automatiquement un historique fiable. Les doublons, les ventes annulées, les erreurs de saisie et les mouvements de stock non enregistrés peuvent fausser les prévisions.
4. L'EDA : comprendre les données avant d'entraîner un modèle
L'analyse exploratoire des données, ou Exploratory Data Analysis (EDA), constitue une étape centrale du projet.
Son rôle est de vérifier la qualité du dataset, de comprendre les comportements de vente et de découvrir les relations qui pourraient être utiles à la prédiction.
4.1. Examiner la qualité des données
La première étape consiste à rechercher les valeurs manquantes, les références produits incohérentes, les quantités négatives non expliquées, les doublons et les périodes pour lesquelles aucune transaction n'a été enregistrée.
Une journée sans vente peut correspondre à une absence réelle de demande, à une fermeture du magasin, à une panne du système ou à une rupture de stock. Ces situations ne doivent pas être considérées automatiquement comme équivalentes.
4.2. Étudier la distribution des ventes
Certains articles sont vendus quotidiennement, tandis que d'autres ne sont demandés que quelques fois par mois.
Les histogrammes, courbes temporelles et tableaux de fréquence permettent d'identifier les produits à forte rotation et ceux dont la demande est irrégulière.
Cette distinction influence les méthodes de prévision. Un modèle efficace pour un produit vendu quotidiennement n'est pas nécessairement adapté à une pièce détachée demandée rarement.
4.3. Rechercher les tendances et la saisonnalité
Les ventes peuvent varier selon les jours, les semaines, les périodes scolaires, certaines fêtes, les promotions ou les caractéristiques particulières d'une activité.
Ces influences doivent être recherchées dans les données plutôt que présumées.
Dans le cas d'un distributeur possédant plusieurs magasins à Kinshasa, Matadi ou Lubumbashi, l'EDA peut également révéler des différences entre les points de vente. Un même produit peut connaître des rythmes de consommation différents selon l'emplacement et la clientèle.
4.4. Identifier les ruptures historiques
Il existe ici un problème méthodologique souvent négligé : les ventes observées ne représentent pas toujours la demande réelle.
Si un magasin vend ses dix dernières unités avant midi, le système peut enregistrer dix ventes pour la journée. Pourtant, d'autres clients ont peut-être souhaité acheter le produit pendant l'après-midi.
La demande non satisfaite n'apparaît alors pas dans les transactions.
En statistique, ce phénomène est notamment étudié comme une observation censurée de la demande. Un modèle entraîné uniquement sur les ventes enregistrées risque de sous-estimer la consommation réelle pendant les périodes de rupture.
C'est pourquoi il est utile de conserver l'historique de disponibilité des articles, et pas seulement leurs ventes.
5. Construire les variables de prédiction
Une fois les données nettoyées et explorées, elles peuvent être transformées en variables utilisables par les modèles.
Par exemple, pour chaque produit et chaque magasin, on peut calculer :
- la quantité vendue la veille ;
- la moyenne des ventes sur les sept derniers jours ;
- la moyenne des ventes sur les trente derniers jours ;
- l'évolution récente de la demande ;
- le jour de la semaine ;
- la présence d'une promotion connue à l'avance ;
- le délai habituel de livraison du fournisseur ;
- le stock disponible au moment de la prévision.
Ces variables doivent être calculées uniquement à partir d'informations réellement connues à la date de prédiction.
Utiliser des ventes futures pour construire une variable censée représenter le passé provoquerait une fuite de données (data leakage). Les performances mesurées pourraient alors paraître excellentes sans être reproductibles en exploitation réelle.
6. Quels algorithmes utiliser ?
Plusieurs approches peuvent être envisagées, selon la quantité de données disponible, la régularité de la demande et la complexité du problème.
Méthodes statistiques
Les moyennes mobiles, le lissage exponentiel et certains modèles de séries chronologiques peuvent constituer d'excellents points de départ.
Ils sont relativement simples à interpréter et fournissent une référence utile pour mesurer la valeur ajoutée éventuelle d'un modèle plus complexe.
Random Forest
Random Forest combine plusieurs arbres de décision. Il peut exploiter des variables historiques, calendaires et commerciales afin d'estimer la demande ou de classer certaines situations selon leur niveau de risque.
CatBoost et autres méthodes de boosting
Les méthodes de boosting comme CatBoost ou XGBoost peuvent être efficaces sur des données tabulaires bien préparées. Elles permettent de représenter des relations non linéaires entre les caractéristiques des produits, les ventes historiques et les facteurs opérationnels.
Le choix final doit dépendre des résultats expérimentaux. Un algorithme sophistiqué n'est pas automatiquement supérieur à une méthode statistique simple.
7. Transformer une prévision en décision de réapprovisionnement
Un résultat de Machine Learning n'a de valeur opérationnelle que s'il peut aider quelqu'un à prendre une décision.
Considérons un exemple fictif. Un commerce vend en moyenne 12 unités d'un article par jour. Son fournisseur met habituellement huit jours pour le livrer. Le magasin conserve également un stock de sécurité de 35 unités.
Dans une approche élémentaire, le point de commande peut être estimé ainsi :
Point de commande = demande quotidienne moyenne × délai de livraison + stock de sécurité.
Dans cet exemple :
12 × 8 + 35 = 131 unités.
Le magasin devrait donc envisager un réapprovisionnement lorsque sa position de stock atteint ce seuil, en tenant compte des commandes déjà engagées et des réceptions attendues.
Ce calcul est volontairement simplifié. Dans un système plus avancé, la demande pendant le délai de livraison et le stock de sécurité peuvent être déterminés à partir de prévisions, de leur incertitude et du niveau de service souhaité.
Le Machine Learning peut améliorer l'estimation de la demande. La politique de gestion des stocks détermine ensuite comment utiliser cette estimation pour décider quand commander et en quelle quantité.
8. Comment vérifier que le modèle fonctionne réellement ?
Une prévision doit être évaluée sur des périodes que le modèle n'a pas utilisées pour apprendre.
Pour les séries temporelles, il faut respecter l'ordre chronologique : entraîner sur des données anciennes, valider sur une période ultérieure et tester sur des observations encore plus récentes.
Plusieurs indicateurs peuvent être utilisés :
- MAE : erreur absolue moyenne entre les quantités prévues et observées ;
- RMSE : mesure d'erreur qui pénalise davantage les écarts importants ;
- Précision et rappel : pertinents lorsque le système prédit directement un risque de rupture ;
- Taux de rupture : fréquence des périodes où la demande ne peut être satisfaite ;
- Taux de service : capacité du système à répondre à la demande ;
- Coûts de stockage et de rupture : conséquences économiques des décisions prises.
La comparaison doit inclure une méthode de référence simple. Si une moyenne mobile donne des résultats comparables à ceux d'un modèle complexe, elle peut être préférable pour une première mise en production.
Il faut également mesurer les effets sur la gestion réelle. Une erreur de prévision plus faible ne garantit pas automatiquement un coût de stock plus faible.
9. Quelles difficultés faut-il anticiper en RDC ?
Un modèle de prévision doit être adapté aux conditions propres à l'entreprise, et non uniquement à ses performances statistiques.
Pour les commerces et distributeurs implantés à Kinshasa, Matadi, Boma, Muanda, Lubumbashi ou Kolwezi, plusieurs questions peuvent se poser : les délais fournisseurs sont-ils réguliers ? Les commandes arrivent-elles toujours en une seule livraison ? Les différents magasins partagent-ils un même dépôt ? Les inventaires sont-ils mis à jour suffisamment souvent ?
Les réponses doivent être obtenues auprès de chaque entreprise. Il serait imprudent de considérer que toutes ces villes ou toutes les activités présentent les mêmes difficultés logistiques.
Un système prédictif utile doit pouvoir intégrer les contraintes réellement observées : variations des délais d'approvisionnement, produits saisonniers, différences entre points de vente, informations manquantes et modifications de la demande.
Il doit également prévoir le cas où les données disponibles sont insuffisantes. Dans cette situation, des règles de gestion classiques et un meilleur suivi des inventaires peuvent apporter davantage de valeur qu'un modèle de Machine Learning.
10. À quoi ressemblerait un système de gestion prédictive des stocks ?
Dans une architecture opérationnelle, le système pourrait associer plusieurs composants :
- Un logiciel de gestion commerciale : enregistrer les ventes, les achats, les fournisseurs et les quantités disponibles.
- Une base de données : conserver l'historique des mouvements et les informations nécessaires à l'analyse.
- Un module Data Science : nettoyer les données, produire les prévisions et évaluer leur fiabilité.
- Un moteur de réapprovisionnement : calculer les seuils et préparer les propositions de commande.
- Un tableau de bord : présenter les articles à risque, les prévisions et les commandes prioritaires.
- Un système d'alertes : prévenir les responsables lorsque des décisions doivent être prises.
Le responsable conserve la possibilité de valider, modifier ou rejeter les propositions. L'automatisation complète des commandes n'est pas nécessairement souhaitable au lancement.
Cette approche peut aussi être étendue à plusieurs points de vente, à condition de définir clairement les règles de transfert de stock, les responsabilités et les délais propres à chaque site.
11. Une entreprise doit-elle nécessairement investir dans l'IA ?
Pas toujours.
Une petite boutique possédant peu de références et des ventes relativement stables peut commencer avec un logiciel de gestion de stock, des seuils de commande et quelques tableaux de suivi.
Le recours au Machine Learning devient plus intéressant lorsque l'entreprise possède un historique suffisant, de nombreuses références, une demande difficile à anticiper ou plusieurs points de vente nécessitant des décisions coordonnées.
La question n'est donc pas seulement de savoir si l'intelligence artificielle peut produire des prévisions. Il faut déterminer si ces prévisions permettront d'améliorer les décisions d'achat à un coût raisonnable.
12. Comment mettre en place une solution adaptée à son entreprise ?
Abyssal AI propose des solutions de gestion commerciale et des stocks, de Data & Business Intelligence et d'intelligence artificielle appliquée aux opérations.
Le catalogue présente des logiciels de gestion de stock et de ventes à partir de 250 USD, ainsi que des offres Business Intelligence, KPI et prévisions à partir de 700 USD. Ces montants correspondent à des configurations de départ. La construction d'un modèle prédictif personnalisé, son intégration et son exploitation nécessitent une évaluation du périmètre réel.
Une première étude peut notamment déterminer :
- si les historiques de ventes sont suffisamment exploitables ;
- quels articles concentrent les risques de rupture ;
- si une méthode statistique simple est suffisante ;
- si un modèle de Machine Learning apporte une amélioration mesurable ;
- comment intégrer les prévisions dans le processus d'approvisionnement.
Les entreprises disposant déjà de fichiers Excel, d'un logiciel commercial ou de plusieurs magasins peuvent commencer par présenter leurs sources de données et leurs difficultés de réapprovisionnement.
Présenter votre projet de prévision ou de gestion des stocks à Abyssal AI.
Conclusion : anticiper plutôt que constater
La prédiction des ruptures de stock est un cas d'application concret du Machine Learning. Elle repose toutefois sur une chaîne complète : collecte des données, analyse exploratoire, construction des variables, prévision, évaluation et décision de réapprovisionnement.
Le point déterminant n'est pas de disposer du modèle le plus complexe, mais d'obtenir des prévisions suffisamment fiables pour commander les bonnes quantités au bon moment.
Pour un commerce, un dépôt ou un réseau de distribution, commencer par fiabiliser les stocks et les historiques de vente reste souvent la meilleure première étape. L'intelligence artificielle peut ensuite apporter une capacité supplémentaire d'anticipation, lorsque les données et les enjeux économiques le justifient.
Références et lectures complémentaires
- Oracle — Reorder Point Planning : principes de calcul des seuils de réapprovisionnement.
- Scikit-learn — Common pitfalls and recommended practices : prévention des fuites de données.
- Trapero, Holgado de Frutos et Pedregal — Demand forecasting under lost sales stock policies, International Journal of Forecasting.
- Abyssal AI — Comment identifier un cas d'usage IA utile et mesurable dans une entreprise en RDC.